
昨天講完 Art-Tracking 要做什麼、不做什麼,今天講用什麼做。這個問題其實是兩個問題疊在一起:
第一,我的其他 side project,像 coffee-review 和 commute,都是靜態前端丟 GitHub Pages、資料放 Supabase,不用自己顧任何一台伺服器。Art-Tracking 為什麼不能也這樣?
第二,Art-Tracking 第一版(2026 年 5 到 7 月)本來就不是靜態的,它跑在 Vercel 上,資料在 Supabase 的 Postgres,Prisma 當 ORM,Cheerio 寫爬蟲,Vercel cron 每天早上七點跑一次,GitHub Actions 每週再兜底打一次。整套是能動的,為什麼第二版要整個搬到 Cloudflare,而不是修一修繼續用?
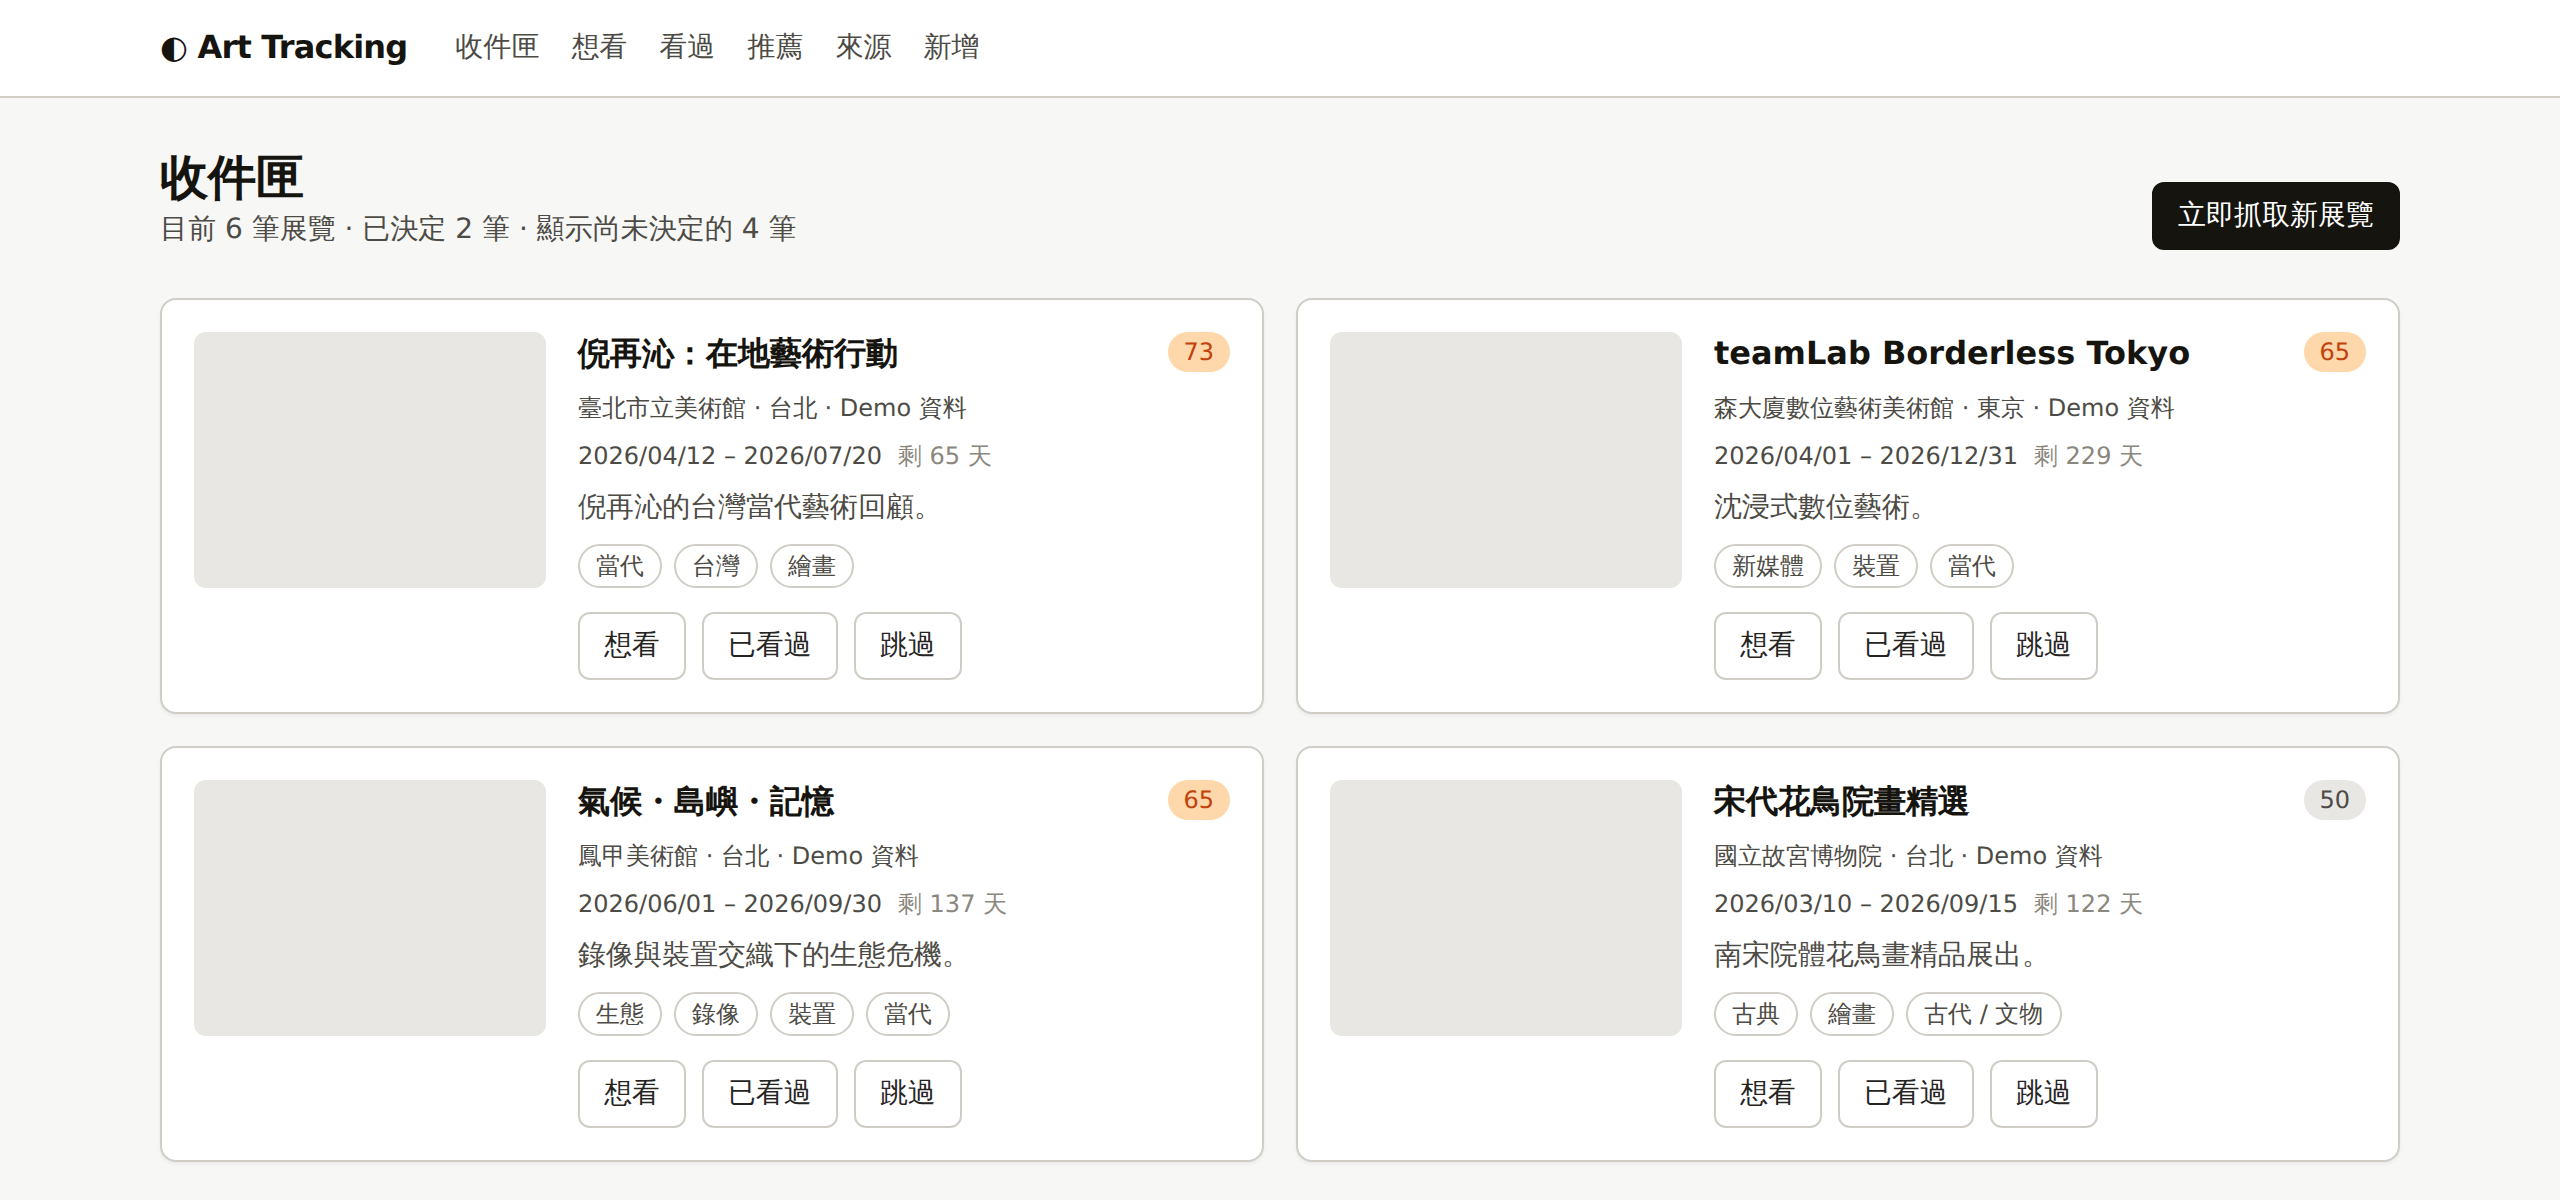
第一版長這樣。收件匣是主頁,每檔展都要按「想看 / 已看過 / 跳過」,右上角的數字是推薦分:
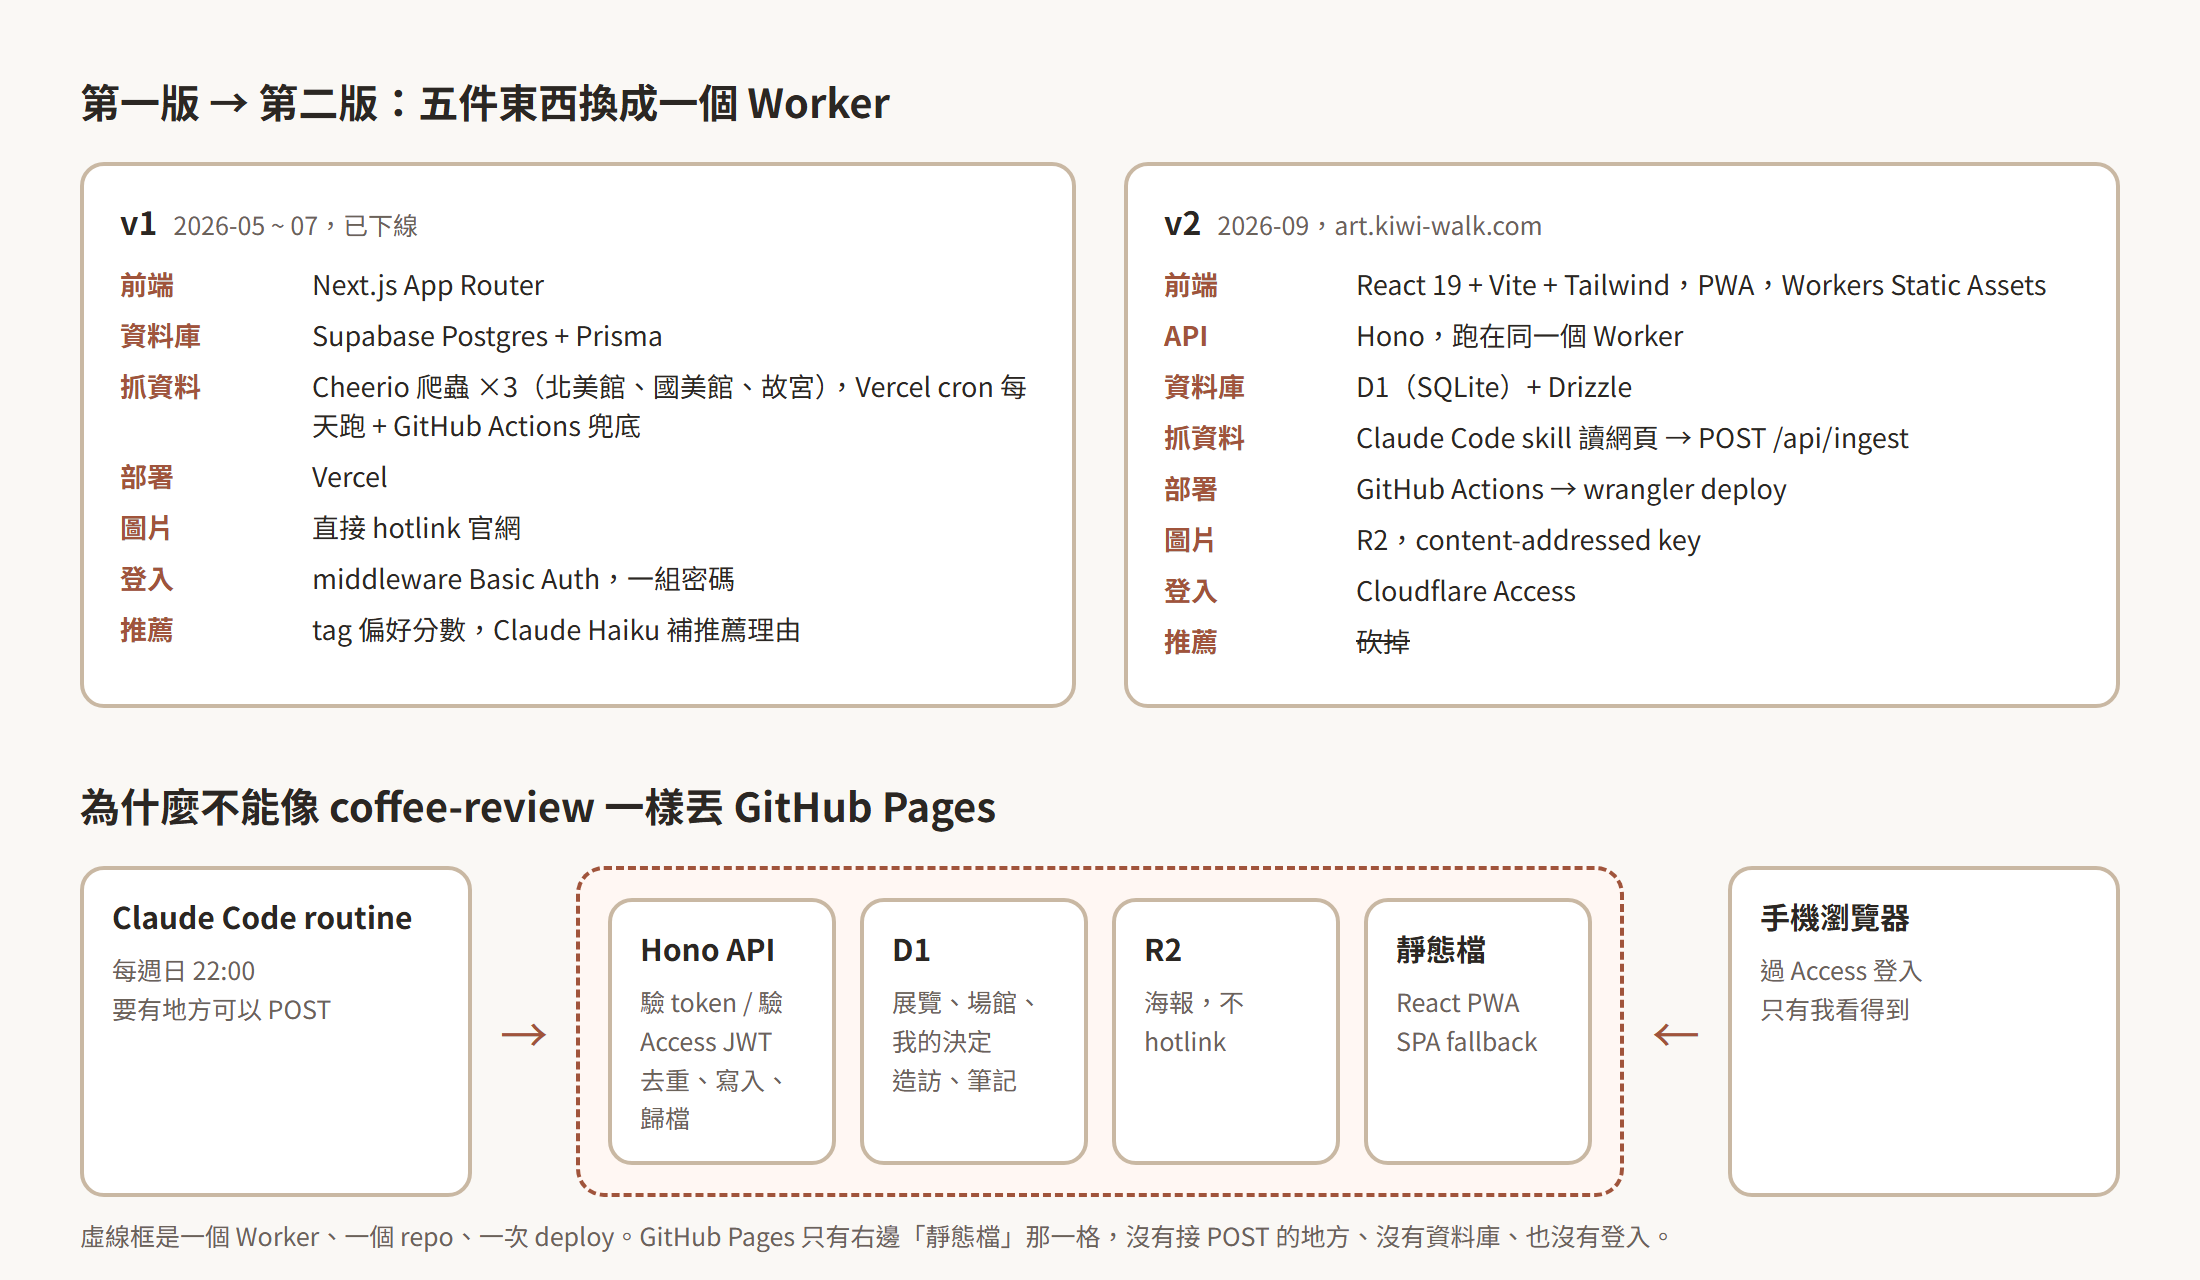
coffee-review 和 commute 都不是只有靜態檔。前端丟 GitHub Pages,資料放 Supabase,瀏覽器拿著公開的 anon key 直接打 Supabase 的 API。這套已經能寫資料、也能擋人:
user_id = auth.uid(),anon 連 coffee schema 的 usage 都沒有。anon 碰不到任何資料表,所有讀寫都走 security definer 的 RPC,函式第一行用 bcrypt 比對一組 secret:create or replace function commute.check_secret(p_secret text) returns boolean
language plpgsql security definer
...
return h is not null and h = extensions.crypt(p_secret, h);
所以「存我自己的資料」和「登入」這兩件事,靜態前端加 Supabase 其實做得到,Art-Tracking 第一版的資料也本來就在 Supabase。會卡住的是另外幾件事:
agent 寫進來的資料要過一段邏輯。 agent 每週日晚上 POST 一批展覽,要去重、判斷哪些是新的、哪些該歸檔。在「前端 + Supabase」的架構裡,這段邏輯只能放在 plpgsql 函式或 Supabase Edge Function(Deno)。commute 就是前者:上下車配對、預測、提醒判斷全寫在 SQL,五個 migration 幾乎都是 create or replace function 和 view。commute 規則少,這樣剛好;但 Art-Tracking 的展覽狀態,前端要顯示、後端要拿來歸檔,寫在 plpgsql 就得在 TypeScript 再寫一份。
排程要拼三塊。 commute 的「上車 40 分鐘還沒下車就推播」,是 pg_cron 定時觸發、pg_net 發 HTTP、再由 Edge Function send-reminders 真的送出 Web Push,三個元件分三處設定,而這只是一個排程。Art-Tracking 要每天歸檔、每週探測暫停的來源。
海報要伺服器去抓。 第一版的 imageUrl 直接指向各館官網,next.config.mjs 裡一排 remotePatterns。官網一改版圖就破,而且每次開頁面都在打人家的伺服器。第二版要自己存一份,但從別人的網站下載圖片會被瀏覽器的 CORS 擋掉,一定要有伺服器端的程式去抓,再放進物件儲存。
資料庫直接對外。 anon key 是公開的,安全全壓在 RLS 和 grant 上。coffee-review 最近幾個 PR 還在補「anon 權限收乾淨(schema usage / sequences / default privileges)」和備份表上鎖,漏一條 grant 就是資料外洩。如果前面有一個後端,資料庫根本不對外,只有後端碰得到。
另外是很現實的額度問題:Supabase 免費方案能開的 project 有限,coffee-review 的 README 就寫著免費 project 用完時,用獨立 schema 跟其他專案共用一個。實際上也是這樣:commute 和 daily 都擠在同一個 Supabase project 裡,daily 的 CLAUDE.md 還特地列出哪幾張表是別的 app 的、不准碰。這個 project 裡除了 commute 和 daily,還有其他 side project 的表,再塞一個 Art-Tracking 進去只會更擠。
所以 Art-Tracking 需要的是「一個小後端 + 一個小資料庫 + 一個小物件儲存 + 登入 + 排程」,而且希望邏輯都寫在同一種語言裡。用 Supabase 拼得出來,但程式碼會散成 SQL、Deno 和前端三份。剩下的問題是這些東西放哪裡。
第一版能動,但每次要改都要碰三個地方:Vercel 的環境變數與 cron、Supabase 的 schema、repo 裡的 Prisma。而且它從來沒有真的穩定過,昨天那篇提到的「GitHub Action 一直失敗,後來就關掉」就是這套。
具體的不順有幾個:
爬蟲是程式碼。 三個爬蟲對三個美術館,每個都是一份 Cheerio selector。畫廊一家都沒有,因為每加一家就是再寫一支爬蟲,寫了又會壞。這點昨天講過,第二版改成 agent 讀網頁,這裡不重複。
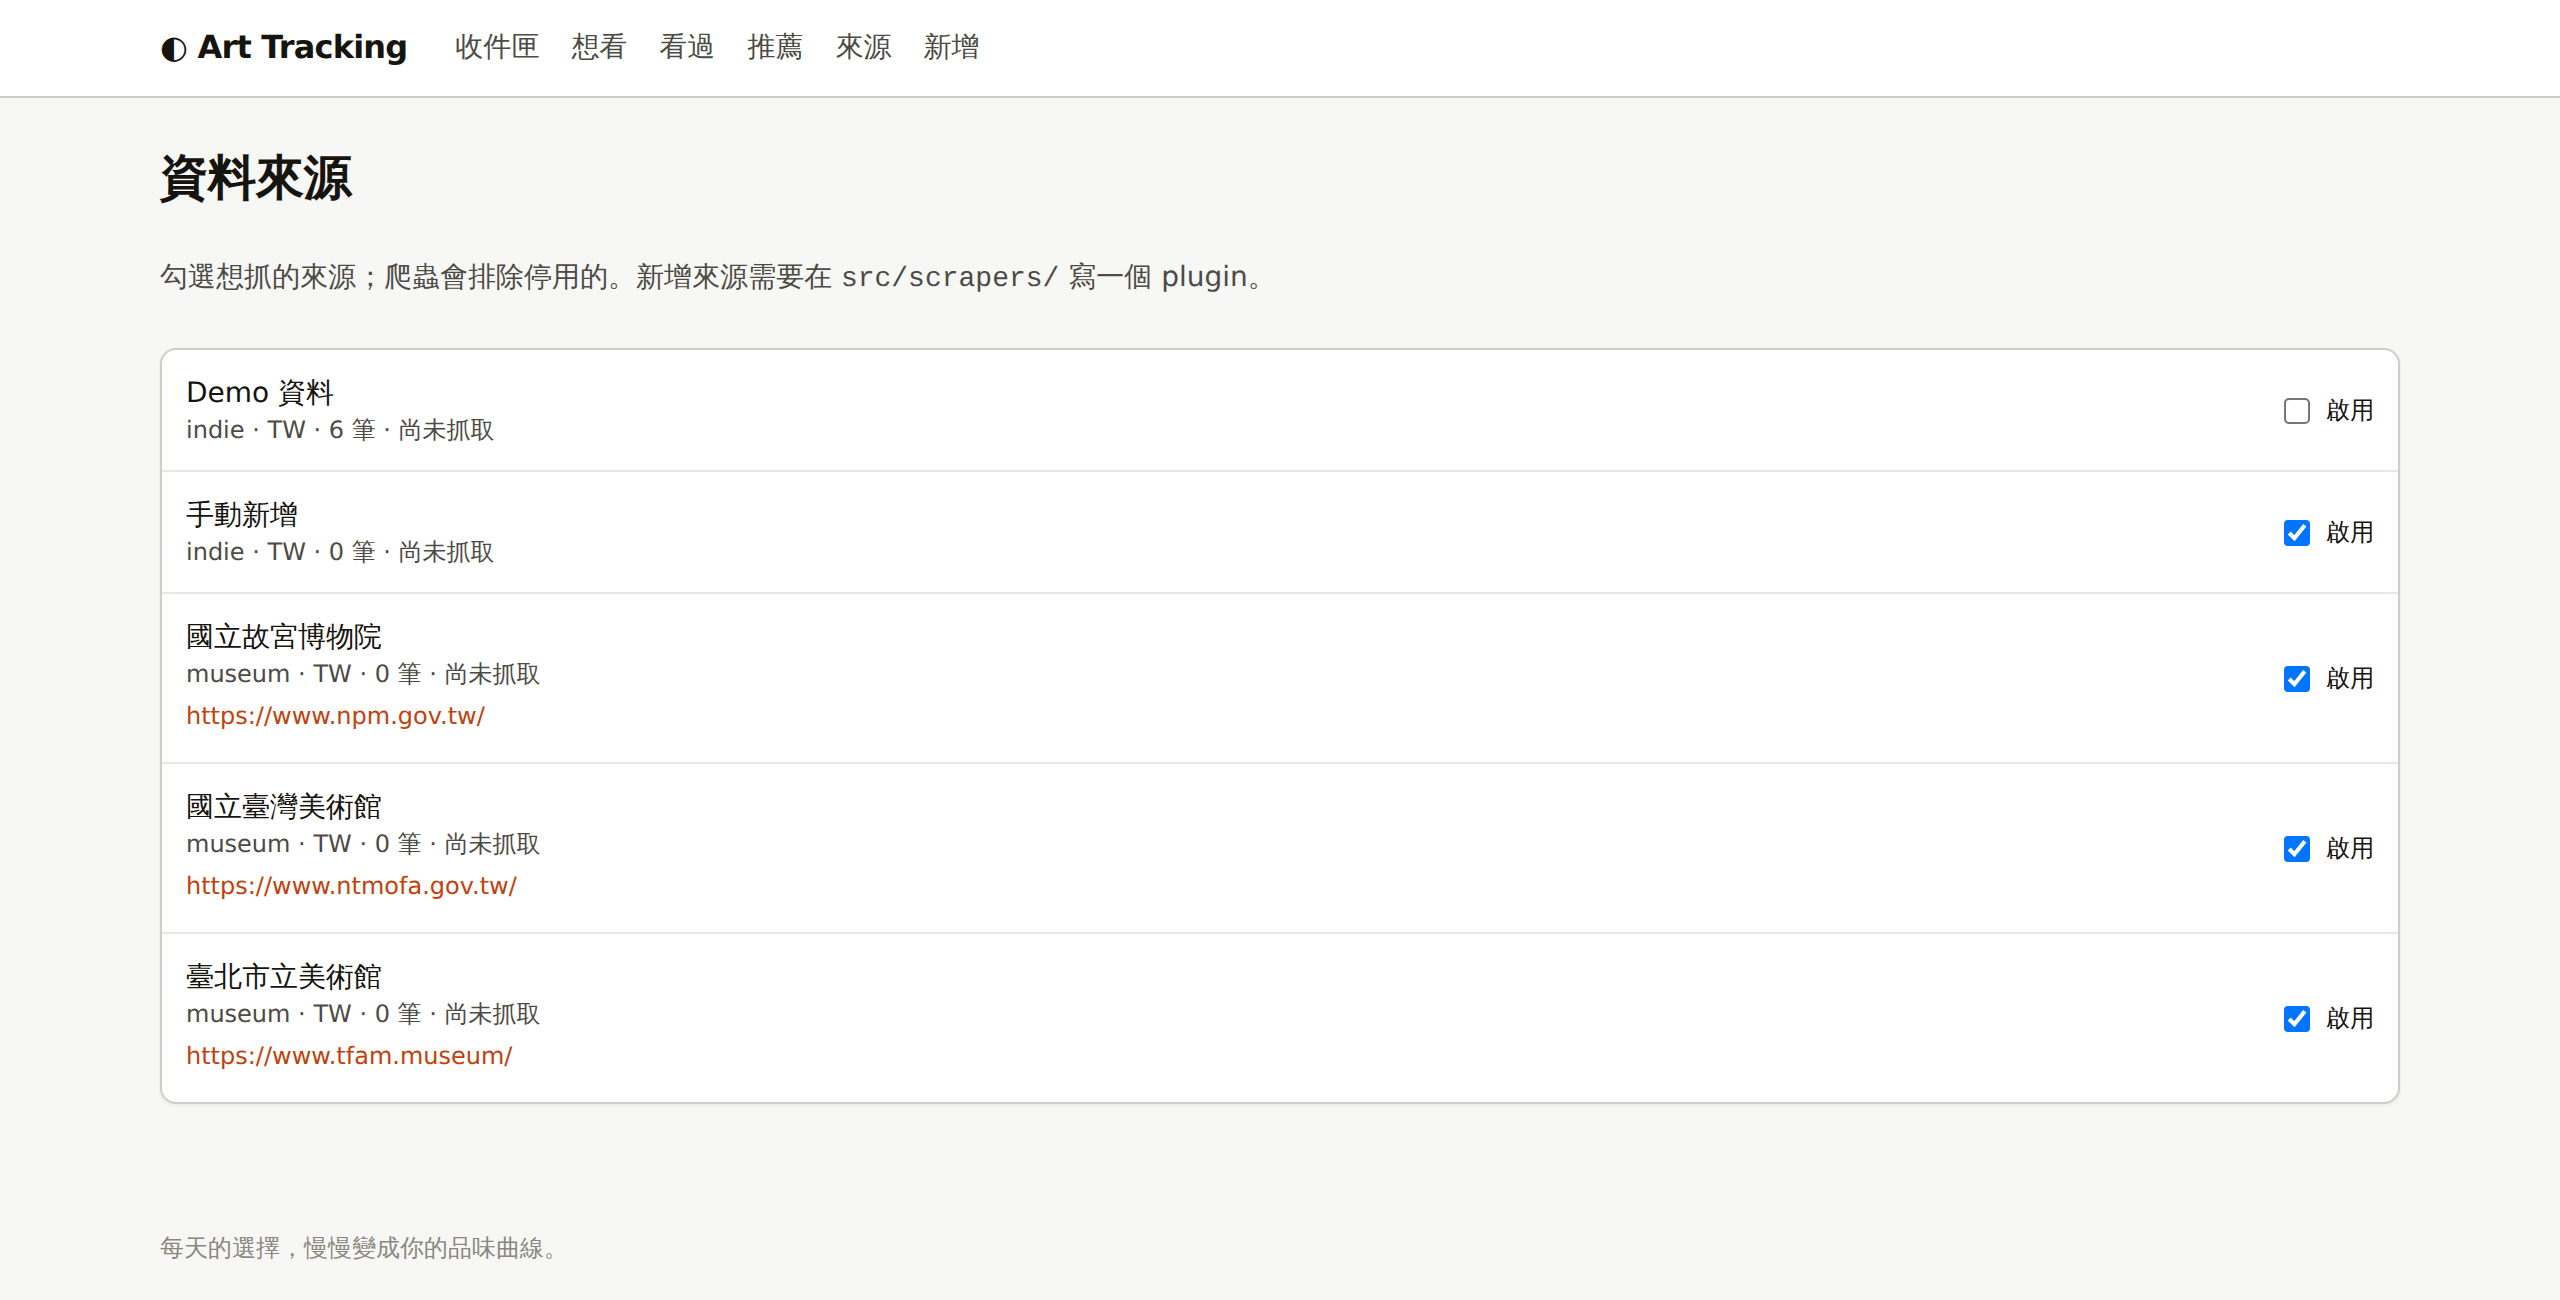
來源頁自己就把問題寫在畫面上了:「新增來源需要在 src/scrapers/ 寫一個 plugin」。
Prisma 在 edge 環境不好用。 第二版一開始就想跑在 Workers 上,Prisma 在 Workers 需要 WASM engine,bundle 很大,計畫裡直接寫「Prisma 在 Workers 上有 WASM 與 bundle 大小問題」,換掉。
登入是一組密碼。 第一版用 middleware 做 Basic Auth,一個 APP_PASSWORD 環境變數,沒設就整站 503。能用,但那是一組所有人共用的密碼,沒有身分概念,也沒有到期或撤銷的方法。
兩個平台兩份帳號。 Vercel 管執行與 cron,Supabase 管資料,圖片還在第三方官網。想加一個 R2 這種物件儲存就變第三個平台。
Cloudflare 的吸引力就是這幾樣東西全在同一個帳號裡:Workers 跑程式、D1 是 SQLite、R2 是物件儲存、Access 是登入、Cron Triggers 是排程,而且我的個人網站 kiwi-walk.com 本來就在 Cloudflare 上,之後掛子網域是零成本。免費額度對單人專案綽綽有餘。
代價是要學新東西。我對 Hono 和 React 都不熟,Drizzle 也沒用過,D1 是 SQLite 不是 Postgres,之前寫的 SQL 有些要改。這個代價我接受,因為第一版已經證明「熟的技術」不代表「會維護」。
決定 Cloudflare 之後還有一個選擇:前端放 Cloudflare Pages、後端放 Workers,兩個專案;或者全部塞進一個 Worker。
選了一個 Worker。Workers Static Assets 可以讓同一個 Worker 同時服務靜態檔和 API:/api/* 和 /img/* 進 Hono,其他路徑回 dist/ 裡的檔案,找不到就回 index.html 讓 React Router 接手。這樣只有一個 wrangler.jsonc、一個 deploy、一個網域、一個 Access application。前後端共用 src/shared/ 裡的型別、zod schema 和狀態計算,不用發 npm 套件也不用 monorepo 工具。
代價是 build 要先跑 Vite 再跑 wrangler,CI 多一步;以及前端改一行也要重新 deploy 整個 Worker。單人專案,這兩個都無所謂。
| 層 | 選擇 | 為什麼 |
|---|---|---|
| API | Hono | Workers 原生,bindings 直接用,middleware 模型跟 Express 一樣好懂 |
| ORM | Drizzle + drizzle-kit | D1 一級支援,bundle 小,migration 就是 SQL 檔 |
| 驗證 | zod | ingest payload 和 API 輸入同一份 schema,前後端共用 |
| 前端 | React 19 + Vite + Tailwind + react-router | 第一版就是 React,元件寫法能延用 |
| PWA | vite-plugin-pwa | manifest、service worker、更新提示一次給 |
| 測試 | Vitest + @cloudflare/vitest-pool-workers |
路由測試真的在 workerd 裡跑,用本地 D1 |
| 排程 | Claude Code routine 抓資料,Workers Cron 做歸檔 | 抓資料需要 agent,歸檔不需要 |
wrangler.jsonc 裡 assets 這段是關鍵:
"assets": {
  "directory": "./dist",
  "binding": "ASSETS",
  "not_found_handling": "single-page-application",
  "run_worker_first": ["/api/*", "/img/*"]
},
run_worker_first 列出的路徑先進 Worker,其餘直接由 Cloudflare 從 dist/ 出檔,連 Worker 都不會被叫起來。not_found_handling: single-page-application 讓 /timeline、/venues/tfam 這種前端路由拿到 index.html。
Worker 本身很薄,就是把幾組路由掛上去,再加一個 scheduled 給 Cron:
const app = new Hono<AppEnv>();
app.onError(onError);
app.route("/", ingestRoutes);
app.route("/", exhibitionRoutes);
app.route("/", visitNoteRoutes);
app.route("/", venueRoutes);
app.route("/", crawlSourceRoutes);
app.route("/", miscRoutes);
// Anything else under /api or /img is a JSON 404 from the Worker, never the SPA shell.
app.notFound((c) => c.json({ error: "not found" }, 404));

export default {
  fetch: app.fetch,
  async scheduled(controller: ScheduledController, env: Env, ctx: ExecutionContext) {
    const db = getDb(env.DB);
    const weekly = new Date(controller.scheduledTime).getUTCDay() === 0;
    ctx.waitUntil(
      (async () => {
        const archived = await archiveStale(db);
        const reachable = weekly ? await probePausedSources(db) : null;
        console.log(JSON.stringify({ job: "housekeeping", archived, reachable }));
      })(),
    );
  },
} satisfies ExportedHandler<Env>;
notFound 那行是個小細節:因為 /api/* 已經進了 Worker,找不到的 API 路徑要回 JSON 404,不能讓它掉回 SPA fallback 變成一頁 HTML,不然前端會把 HTML 當成登入頁而整頁 reload。
第一版有 POSTGRES_PRISMA_URL、POSTGRES_URL_NON_POOLING 兩條連線字串要在 Vercel 和本機各設一次。第二版的 D1 和 R2 是 binding,寫在 wrangler.jsonc,本機 wrangler dev 自動給你一份本地的:
"d1_databases": [
  { "binding": "DB", "database_name": "art-tracking", "database_id": "…", "migrations_dir": "drizzle" }
],
"r2_buckets": [
  { "binding": "IMAGES", "bucket_name": "art-tracking-images" }
],
"triggers": { "crons": ["0 23 * * *"] },
程式碼裡拿到的就是 env.DB 和 env.IMAGES,沒有 URL、沒有密碼。唯一的 secret 是 agent 用的 INGEST_TOKEN,用 wrangler secret put 設一次。
這是換到 Cloudflare 之後最意外的好處。@cloudflare/vitest-pool-workers 讓路由測試在 workerd 裡執行,D1 和 R2 都是 in-memory 的 miniflare,migration 在測試啟動時套上去:
const migrations = await readD1Migrations(fileURLToPath(new URL("./drizzle", import.meta.url)));

export default defineConfig({
  test: {
    projects: [
      { test: { name: "shared", include: ["test/shared/**/*.test.ts"], environment: "node" } },
      { test: { name: "web", include: ["test/web/**/*.test.tsx"], environment: "jsdom", globals: true, setupFiles: ["test/web/setup.ts"] } },
      {
        test: { name: "worker", include: ["test/worker/**/*.test.ts"], setupFiles: ["test/worker/setup.ts"] },
        plugins: [
          cloudflareTest({
            wrangler: { configPath: "./wrangler.jsonc" },
            miniflare: { bindings: { INGEST_TOKEN: "test-token", ALLOW_TODAY_OVERRIDE: "1", TEST_MIGRATIONS: migrations } },
          }),
        ],
      },
    ],
  },
});
三個 project 對應三種程式碼:shared 純 TypeScript 在 node 跑,web React 元件在 jsdom 跑,worker 在 workerd 跑。第一版 repo 裡一個測試檔都沒有,因為要測 API 得先起 Docker Postgres,就一直沒寫。第二版有 119 個測試,每個 PR 都跑。
- run: npm run typecheck
- run: npm run lint
- run: npm test
- run: npm run build
# Validates wrangler.jsonc and bundles the worker without an API token.
- run: npx wrangler deploy --dry-run --outdir .wrangler/dry-run
wrangler deploy --dry-run 會完整打包 Worker 並檢查設定檔,但不上傳,所以每個 PR 都能確認「這個 commit 是可以部署的」,不用把 Cloudflare token 給 PR 用。真正的部署只在 main 跑,明天會講到的 deploy.yml 就是那條。
這篇是選型,沒有真的卡關的地方。有一個容易誤判的:wrangler.jsonc 的 compatibility_date 一開始填了當天的日期,wrangler 直接拒絕,因為那個日期比它認得的最新 runtime 還新。往前填幾週(現在是 2026-08-15)就過了。
今天定下來:不走 coffee-review 那套 GitHub Pages + Supabase,因為 agent 寫入的去重、排程、抓海報都需要伺服器端程式,在 Supabase 會散成 SQL、Edge Function 和 pg_cron 三處,而且資料庫直接對外;不留 Vercel + Supabase,因為三個平台三份設定、Prisma 在 edge 上不順、登入只是一組密碼;改成一個 Cloudflare Worker 同時放 Hono API、D1、R2 和 React PWA,測試在 workerd 裡跑,CI 用 dry-run 驗設定。明天處理上線後的第一個問題:掛到 art.kiwi-walk.com,並用 Cloudflare Access 把整站鎖在登入後面。


 iThome鐵人賽
 看影片追技術